État des services
La page ne s’actualise pas d’elle-même : chaque valeur est relevée à l’ouverture, ou lorsque vous cliquez sur Actualiser, en haut à droite.
Vue générale
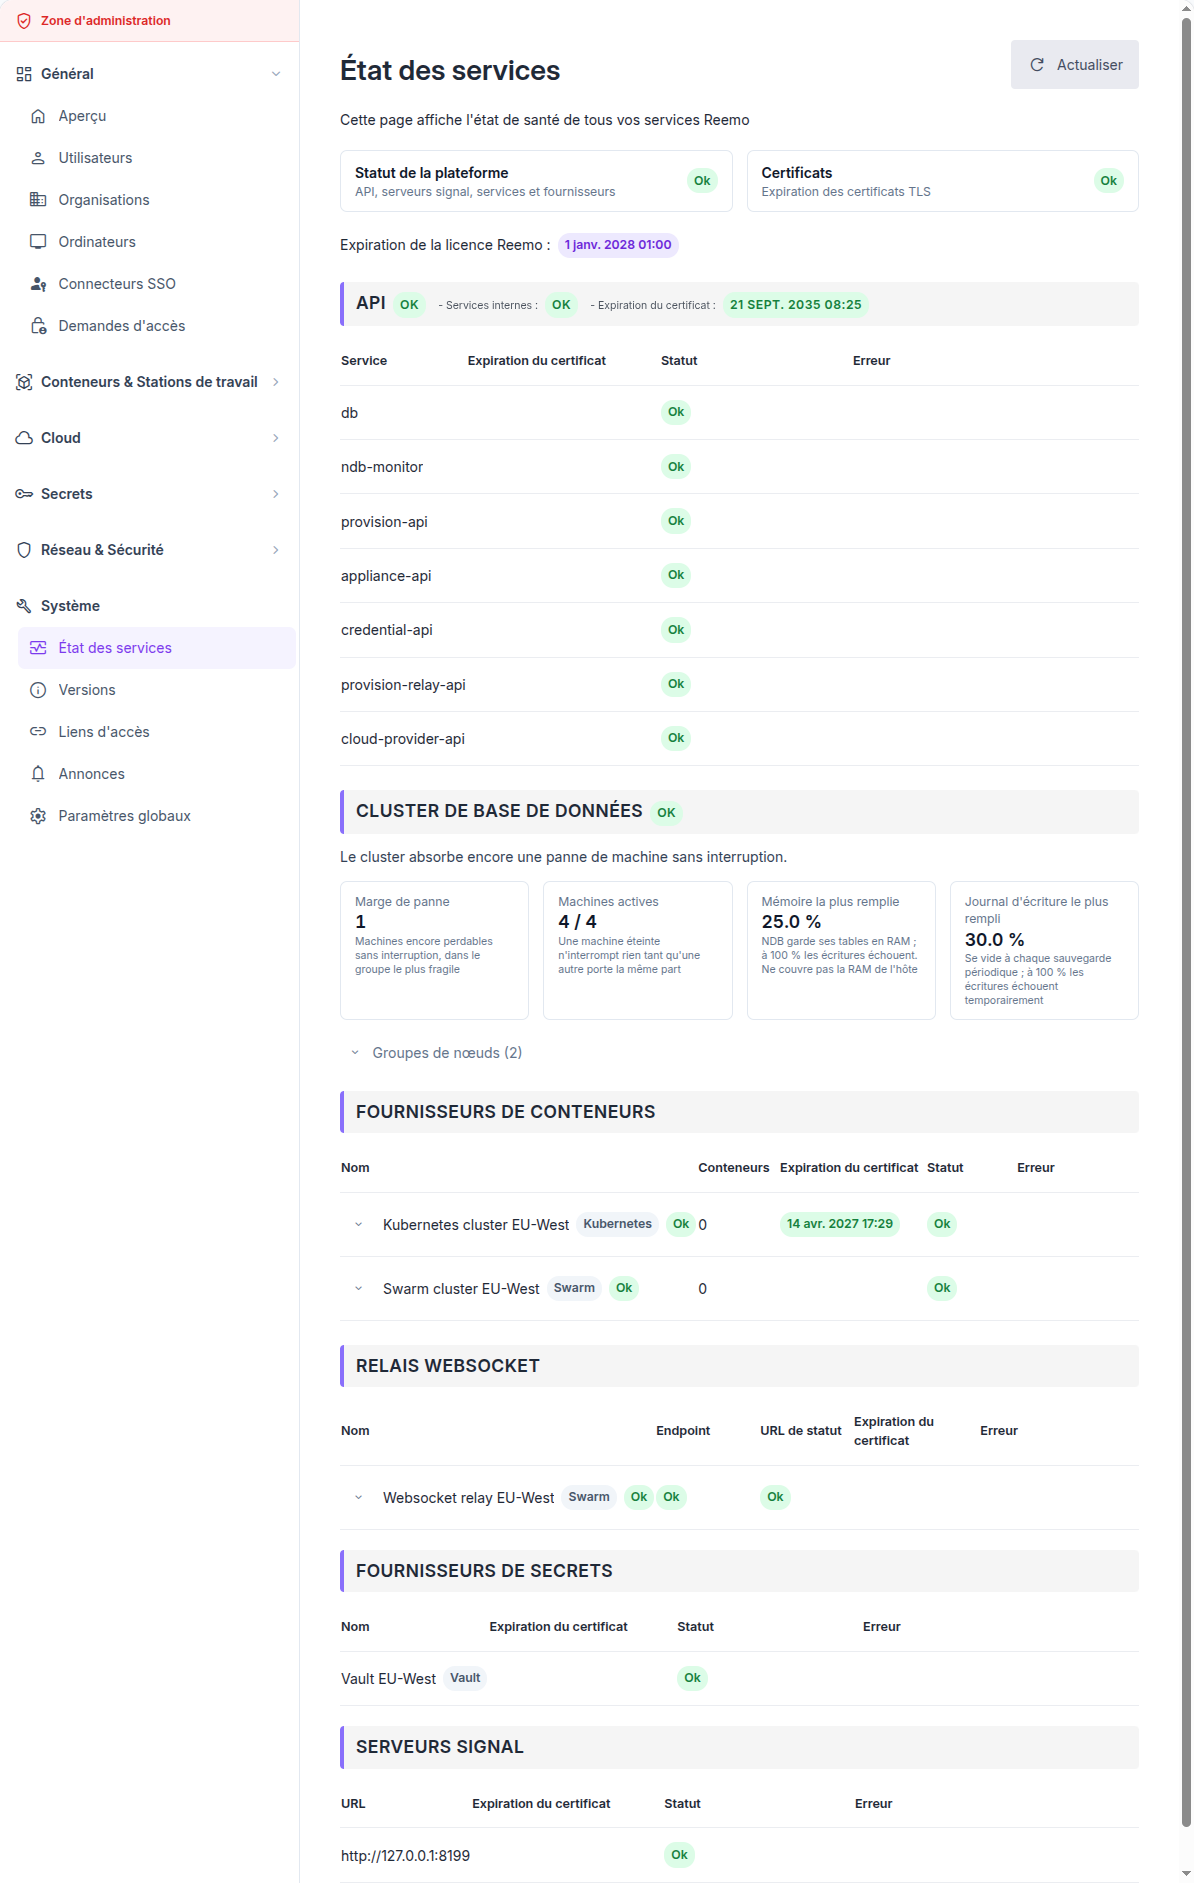
La page État des services sur une plateforme opérationnelle
La page est organisée ainsi :
Deux tuiles résument la plateforme et les certificats TLS qu’elle utilise.
Une section par famille de services liste chaque entrée avec son statut et, en cas d’échec, son erreur.
Un bouton Détail des nœuds ouvre, pour un fournisseur de conteneurs ou un relais websocket, l’état de chaque nœud du cluster.
Statut de la plateforme et certificats
Survolez une tuile pour lister ce qui l’a fait sortir de l’état Ok.
Statut de la plateforme couvre l’API, les serveurs signal, les services internes et les fournisseurs :
Erreur : l’API ne répond pas, ou l’un de ses services internes est hors service, ou tous les serveurs signal sont hors service.
Avertissement : une partie des serveurs signal est hors service, ou au moins un fournisseur est en erreur, ou le cluster de base de données est dégradé tout en continuant à servir.
Ok : aucun des cas ci-dessus.
Certificats couvre tous les certificats TLS connus de la page, face à deux seuils réglés sur l’instance :
Erreur : un certificat n’a pas pu être lu, ou expire dans le délai du seuil d’erreur.
Avertissement : un certificat expire dans le délai du seuil d’avertissement.
Ok : tous les certificats sont lisibles et hors des deux seuils.
Note
Un cluster dont des nœuds sont en erreur ne fait pas basculer la tuile Statut de la plateforme : tant que le cluster répond par son point d’entrée, le service reste disponible. Seul le diagnostic par nœud le signale.
Sections détaillées
API
Cette section regroupe les services internes nécessaires au fonctionnement de Reemo. Son en-tête affiche trois informations : le statut de l’API, celui des Services internes et l’expiration du certificat de l’API.
Le statut de l’API seule passe en erreur quand la base de données est injoignable. Les autres services du tableau alimentent le statut des Services internes :
db : la base de données,
provision-api : le provisioning des conteneurs,
provision-relay-api : le provisioning des relais websocket,
credential-api : les fournisseurs de secrets,
cloud-provider-api : les intégrations avec les fournisseurs cloud,
appliance-api : les appliances enregistrées sur l’instance.
Cluster de base de données
Cette section apparaît sur une instance dont la base de données tourne sur un cluster MySQL NDB, et dont le service de supervision est activé. Elle indique combien de pannes le cluster peut encore absorber.
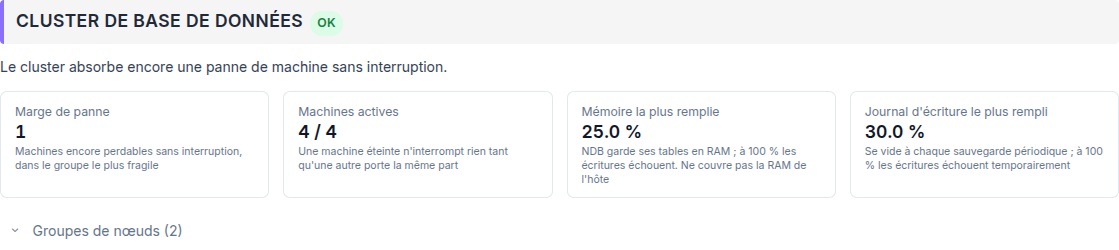
Un cluster de base de données sain
Marge de panne : le nombre de machines encore perdables sans interrompre le service, compté dans le groupe le plus fragile.
Machines actives : les machines de données vivantes sur le total.
Mémoire la plus remplie : NDB garde ses tables en RAM ; à 100 % les écritures échouent.
Journal d’écriture le plus rempli : se vide à chaque sauvegarde périodique ; à 100 % les écritures échouent temporairement.
Une phrase au-dessus des tuiles résume la situation. En dessous, chaque raison nomme une anomalie, avec son détail technique en gris. Groupes de nœuds liste chaque groupe, les machines qu’il contient et le nombre de copies encore vivantes.
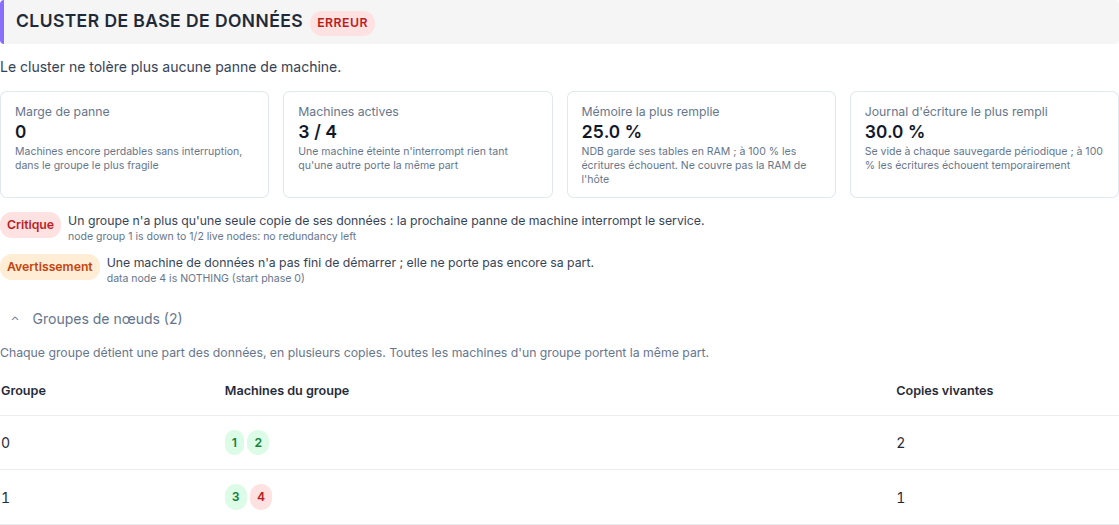
Un cluster qui ne tolère plus aucune panne de machine
Note
Un cluster dégradé sert toujours : le service reste Ok dans le tableau du dessus. La nuance apparaît dans le badge de cette section et dans la tuile Statut de la plateforme, qui affiche Avertissement.
Fournisseurs de conteneurs
Cette section liste les clusters de conteneurs configurés sur l’instance, une ligne par cluster. Chaque ligne porte le nom du fournisseur et son type, le nombre de conteneurs qu’il exécute, l’expiration de son certificat, son statut et son erreur.
Relais websocket
Cette section liste les relais websocket, une ligne par relais. Endpoint et URL de statut sont sondés séparément : un relais répond sur l’endpoint de son cluster pour être piloté, et sur son URL de statut pour être joint par un client.
Fournisseurs de secrets
Cette section liste les fournisseurs de secrets configurés sur l’instance, avec le statut renvoyé par chaque coffre.
Serveurs Signal
Les serveurs Signal établissent les connexions WebRTC entre les utilisateurs et les ressources. Chaque ligne indique l’URL du serveur, l’expiration de son certificat et son statut.
Détail des nœuds
Un fournisseur de conteneurs et un relais websocket se trouvent chacun devant un cluster de plusieurs machines. Les colonnes de statut de leurs tableaux rapportent le cluster dans son ensemble, à travers son point d’entrée : un cluster qui a perdu un nœud continue donc de répondre et d’afficher Ok.
Le badge à côté du nom rapporte le cluster nœud par nœud. La flèche qui le précède ouvre le détail.
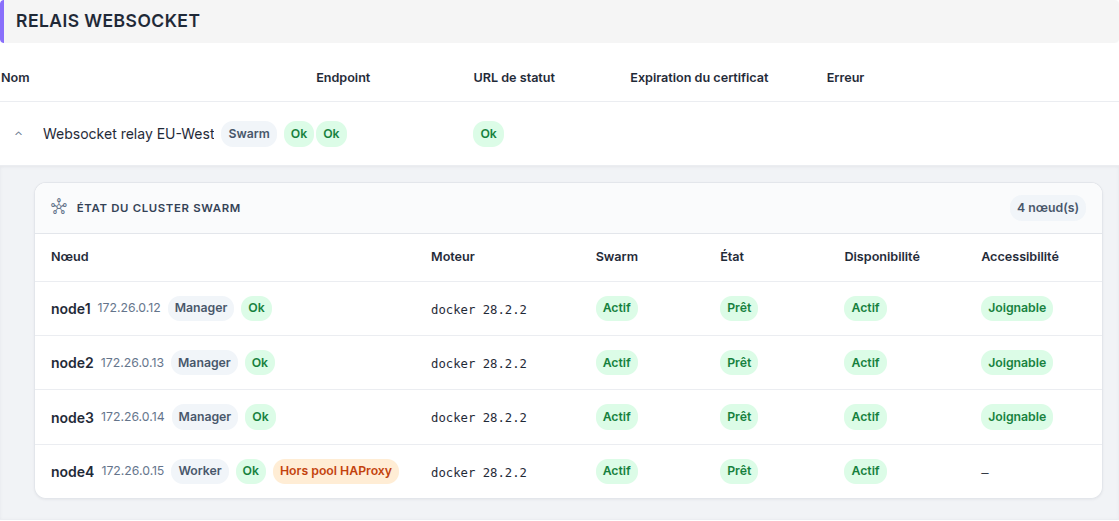
Un relais dont les quatre nœuds sont opérationnels
Sur la capture ci-dessous, Endpoint et URL de statut sont tous deux Ok, car HAProxy continue de router vers les nœuds survivants. Le badge affiche Erreur parce qu’un nœud a cessé de répondre.
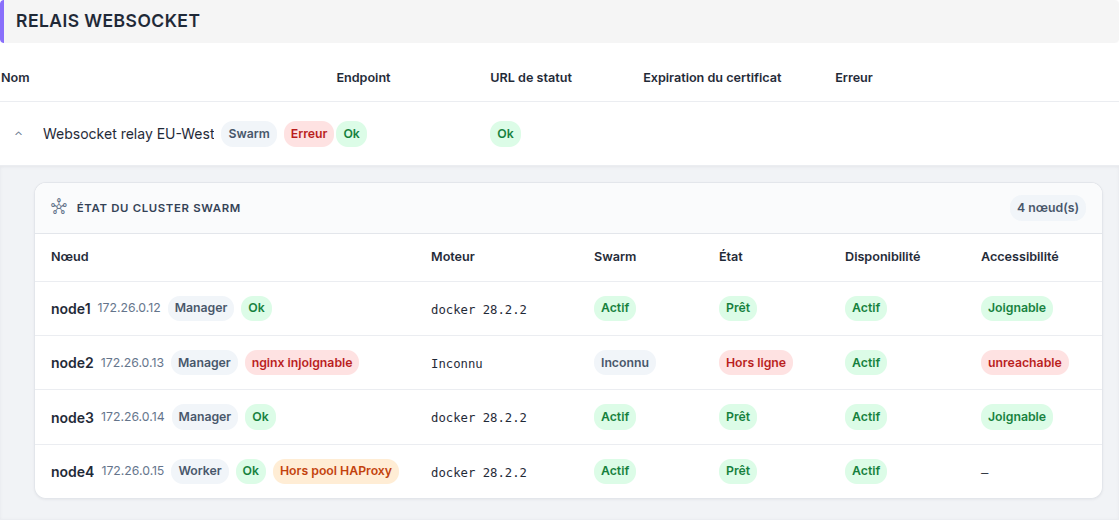
Un nœud hors service derrière un relais qui répond toujours
Le badge prend quatre valeurs :
Ok : chaque nœud est dans l’état que son rôle exige.
Avertissement : une anomalie sans perte de service, sur un nœud dont on n’attend pas de trafic.
Erreur : au moins un nœud censé porter du trafic ne le fait pas.
non disponible : le diagnostic n’a pas pu être exécuté, par exemple pendant qu’une appliance est hors ligne.
See also
Diagnostic des nœuds — tous les états de nœud, les règles d’agrégation et la lecture des statistiques HAProxy.
Fonctionnement
Rafraîchissez la page avec le bouton Actualiser, en haut à droite.
Quand un service échoue, la colonne Erreur en donne la raison. Survolez-la pour lire le texte complet et le copier.
Consultez cette page régulièrement : elle signale un certificat proche de l’expiration, un service arrêté ou un cluster qui a perdu sa redondance.